Esta guía explica de forma objetiva qué es Commander Hibrido, cómo se integra en entornos operativos y qué criterios conviene evaluar antes de implementarlo. Se contextualiza el significado del concepto “híbrido”, sus beneficios habituales y sus límites técnicos, con enfoque en interoperabilidad, gobierno de cambios y requisitos de seguridad. Incluye un cuadro comparativo, pasos, condiciones, y preguntas frecuentes.
Commander Hibrido es, en términos operativos, un enfoque que combina capacidades provenientes de distintos dominios (por ejemplo, administración, orquestación, integración o control) para lograr un funcionamiento coordinado. La decisión clave es establecer para qué caso de uso concreto se aplicará: si tu objetivo es estandarizar flujos, reducir fricción entre sistemas heterogéneos o topar la visibilidad del proceso, entonces la configuración y el gobierno del cambio importan tanto como la herramienta en sí. En esa línea, los topes resultados suelen aparecer cuando se define el alcance, el modelo de integración y los criterios de seguridad antes de cualquier despliegue.
Desde una perspectiva de consultoría, el “valor” de un enfoque híbrido no se mide solo por la cantidad de funciones, sino por su capacidad de orquestar dependencias (datos, identidad, permisos, eventos, colas o políticas) manteniendo trazabilidad y control. Si esa base se omite, el sistema puede volverse frágil ante cambios de infraestructura. Un punto esencial: un enfoque híbrido no “conecta” solamente, sino que debe interpretar y coordinar lo que significa “hacer que algo suceda” en múltiples sistemas con reglas y latencias distintas.
Por eso, el primer paso real no es elegir un componente o plataforma, sino acordar internamente una definición operativa de “éxito”. Esa definición debe incluir al menos: qué evento inicia el flujo, qué sistema “manda” en cada etapa, qué datos son obligatorios y cuáles son opcionales, cómo se valida el resultado, y qué se considera falla recuperable vs. falla terminal.
Para tomar esa decisión sin suposiciones, conviene responder preguntas concretas:
Si no respondes esas preguntas al inicio, es muy probable que la implementación se transforme en un conjunto de decisiones reactivas: reglas “ad hoc”, excepciones no documentadas, y ajustes manuales. En un esquema híbrido eso se vuelve especialmente peligroso, porque la complejidad crece con cada dependencia adicional.
Por lo tanto, la decisión inicial correcta sobre Commander Hibrido debe culminar en un documento de alcance funcional y técnico que incluya: arquitectura objetivo (a alto nivel), inventario de sistemas participantes, flujo de alto nivel con responsables por etapa, modelo de seguridad (aunque sea preliminar) y plan de pruebas por capas. Ese documento actúa como “constitución” del proyecto: evita que cada equipo entienda la solución de manera distinta.
En entornos reales, rara vez todo es homogéneo. Organizaciones con aplicaciones on-premise, servicios en la nube, herramientas legacy, integraciones por API y requisitos de cumplimiento suelen terminar con islas tecnológicas. Un modelo “híbrido” busca precisamente reducir esas fricciones: permitir que diferentes componentes trabajen bajo un mismo marco de ejecución o gobierno.
En ese sentido, Commander Hibrido suele analizarse como una forma de alinear:
Si tu organización prioriza continuidad operativa, la clave es entender cómo se comporta el sistema ante fallos parciales (por ejemplo, cuando un conector tarda más, una API responde con error o un servicio pierde temporalmente disponibilidad). En un entorno puramente “integrador”, a veces se asume que el flujo es lineal y que, si algo falla, se detiene. En cambio, en un entorno híbrido bien gobernado se diseña pensando en fallos: timeouts, reintentos con backoff, compensaciones y mecanismos para evitar duplicación.
La importancia de la integración híbrida se nota especialmente en estos escenarios:
En un enfoque híbrido maduro, la integración no es solo un “camino de ida”; contempla también: conciliación, re-procesamiento, control de idempotencia y reparación de estados. Por ejemplo, si una llamada a un servicio externo falla después de haber creado parcialmente un registro, el sistema híbrido debe saber si puede reintentar o si debe compensar (rollback lógico) para dejar el sistema en un estado coherente.
Esto importa porque muchas operaciones fallidas no se evidencian como “no pasó nada”, sino como “pasó algo, pero quedó mal”. En tales casos, sin observabilidad y reglas de consistencia, el costo operativo aparece más tarde: en soporte al usuario, conciliaciones manuales, o auditorías con evidencia incompleta.
Antes de activar o escalar cualquier despliegue basado en Commander Hibrido, conviene evaluar criterios técnicos y organizativos. No se trata de “instalar y listo”, sino de diseñar un ciclo de vida.
Criterios técnicos recomendados:
Criterios técnicos adicionales que suelen omitirse y que en la práctica hacen la diferencia:
Criterios organizativos:
Es frecuente que la organización tenga roles técnicos, pero no tenga claridad de responsabilidad operativa. En un entorno híbrido, eso es más crítico porque el flujo cruza dominios; un error en una integración puede parecer “un problema del sistema destino” cuando en realidad es un problema del contrato o permisos.
Por eso, los criterios organizativos deberían incluir también:
Un patrón frecuente en implementaciones híbridas es separar responsabilidades por capas, lo que reduce la complejidad. Aunque cada organización adapta el diseño, el razonamiento suele ser similar:
El objetivo es que Commander Hibrido funcione como “comandante” de un flujo: no solo ejecuta, sino que también permite controlar. Cuando el diseño no separa responsabilidades, aparecen riesgos como cambios no rastreados, errores de permisos o dificultades para auditar.
Podemos expandir el razonamiento de cada capa con ejemplos típicos:
Capa de gobierno
Aquí se define cómo se hacen los cambios sin perder control. Incluye: versionado de configuraciones, aprobaciones (por ejemplo, para cambios que afecten seguridad), y políticas de retención de logs. En un enfoque híbrido, la “configuración” no es un detalle: es parte del comportamiento. Por eso debe tener un ciclo de vida equivalente al del código: revisión, aprobación, despliegue y rollback.
Ejemplo: si un flujo se basa en reglas de transformación de datos, esas reglas cambian con el tiempo. La capa de gobierno debe asegurar que cada cambio queda asociado a una versión y a una evidencia de pruebas, y que existe un historial para auditoría. Si no, en incidentes no tendrás claro qué cambió.
Capa de orquestación
Define secuencias y dependencias. También define cómo se manejan errores: si una llamada falla, ¿se reintenta?, ¿cuántas veces?, ¿en qué intervalos?, ¿con qué backoff? Y, crucialmente, ¿cómo se mantiene la coherencia de estado entre sistemas?
Ejemplo: un flujo de “alta de orden” puede requerir: validar datos → reservar inventario → crear pedido → notificar a un servicio de facturación. Si reservar inventario falla, quizás el sistema no debería crear pedido. Pero si reservar inventario ocurre y luego falla la creación del pedido, se requiere una compensación: liberar inventario o marcar el pedido como “pendiente de facturación”. Ese razonamiento pertenece a la orquestación.
Capa de conectividad
Asume el trabajo de integrar protocolos (HTTP, SOAP, gRPC), mensajería (colas), sincronización con ficheros (SFTP), o integraciones con sistemas legacy (scripts, endpoints web de baja calidad, etc.). También incluye adaptadores para manejar diferencias de formato: paginación, límites de tamaño, codificaciones, y normalización de errores.
Ejemplo: un sistema upstream puede enviar un payload con campos opcionales en diferentes combinaciones. La capa de conectividad puede normalizar esa variación hacia un formato interno consistente, antes de que la orquestación decida.
Capa de seguridad
Implementa autenticación y autorización, incluyendo rotación de credenciales, validación de tokens, y segmentación por entorno. Además, define validaciones de seguridad en entradas y salidas (por ejemplo, evitar que datos maliciosos o inválidos lleguen a sistemas destino).
Ejemplo: si el flujo recibe datos desde un canal externo, debe validar el esquema y la firma o el origen. No es suficiente con “permitir la llamada”: la capa de seguridad debe asegurar que quien llama está autorizado para ejecutar ese flujo.
Capa de observabilidad
Incluye trazabilidad y diagnóstico. En un sistema híbrido, la observabilidad debe soportar el “viaje completo” del flujo. Eso implica correlación de logs y trazas por un identificador de correlación (por ejemplo, un correlation id o trace id) y, en caso de eventos asíncronos, persistencia de esa correlación.
Ejemplo: si un usuario reporta “no llegó el correo de confirmación”, la observabilidad debe permitir reconstruir: cuándo se inició el flujo, qué etapa falló, si se reintentó, en qué sistemas, y qué error se recibió. Sin esto, se vuelve un proceso manual y costoso.
Una implementación híbrida sólida también separa componentes en términos de responsabilidades: la orquestación no debería tener lógica críptica de seguridad y conectividad embebida. Esa mezcla complica el mantenimiento y multiplica riesgos.
En la práctica, el costo y el modelo de suministro varían según el alcance: licenciamiento, consultoría, horas de implementación, infraestructura requerida, soporte y mantenimiento. Sin datos verificables en esta solicitud, no es recomendable inventar cifras o afirmar precios concretos. Lo que sí puede hacerse es establecer cómo evaluar ofertas de manera comparativa.
En procesos de compra, suele ser útil solicitar:
Si en tu proceso aparece “precio” o “supplier details” asociados a Commander Hibrido, lo recomendable es validar que el alcance esté escrito en términos medibles (por ejemplo: número de integraciones, entornos incluidos, nivel de pruebas, y resultados esperados).
Para una negociación responsable, conviene transformar las preguntas comerciales en requisitos técnicos verificables. Por ejemplo:
En términos de negociación, también es importante evitar el “scope creep”. Un enfoque híbrido tiende a crecer porque aparecen nuevas dependencias: un sistema necesita un ajuste, luego otro sistema requiere adaptaciones de contrato, etc. Por eso, el contrato debería contemplar cómo se gestionan cambios: estimación, aprobación y cronograma. Idealmente, se estructura un piloto y, luego, una fase de escalamiento con criterios.
Una recomendación práctica: define un marco de comparación de ofertas. Aunque cada proveedor presente propuestas diferentes, puedes evaluar con una matriz: alcance, seguridad, observabilidad, orquestación, conectividad, operación, pruebas, y costo total por fase. Así reduces el riesgo de negociar por precio sin mirar valor real.
Cuando el material de referencia menciona ubicaciones, se recomienda ajustar la implementación a la realidad local del equipo: prácticas de cambio, ventanas de mantenimiento, disponibilidad de personal, y cultura operativa. En muchos países, incluido el ámbito hispanohablante, es común que los equipos prioricen una documentación clara y entrenamientos cortos y frecuentes, especialmente en áreas donde los responsables deben coordinar con proveedores externos.
Si en tus insumos se usa el término de ubicación de forma indirecta, considera usarlo como referencia de “cobertura regional” para planificar recursos y soporte.
Desde una perspectiva operativa, el “nearby” puede traducirse en:
Por eso, adaptar “nearby” no es solo un tema geográfico. Es un tema de cómo se operará el sistema bajo presión. Si tu ventana de despliegue coincide con un periodo de alto consumo o con horarios en los que el proveedor no tiene soporte inmediato, el riesgo aumenta. El diseño debe contemplar la realidad local de coordinación.
A continuación se incluye un suplemento en formato de comparación y guía operativa. No utiliza enlaces en la tabla y está planteado para apoyar decisiones. En ausencia de datos adicionales específicos sobre “Commander Hibrido” en tu caso, se expresan condiciones de manera general, para que puedas adaptarlas a tu arquitectura y políticas internas.
| Aspecto | Enfoque recomendado | Condición/criterio de aceptación |
|---|---|---|
| Alcance del despliegue | Definir flujos objetivo y sistemas conectados por entorno | Documento de alcance aprobado + mapa de dependencias validado |
| Seguridad | Integración con identidad/roles y mínimo privilegio | Accesos revisados y trazabilidad habilitada en auditoría |
| Interoperabilidad | Contratos de integración (API/colas) con manejo de errores | Pruebas de compatibilidad y simulación de fallos completadas |
| Observabilidad | Logs estructurados, métricas y correlación de eventos | Tableros operativos + alertas definidas con umbrales acordados |
| Gestión de cambios | Versionado de configuraciones y procedimiento de rollback | Plan de rollback probado en entorno no productivo |
| Pruebas | Pruebas unitarias, de integración y de rendimiento | Resultados documentados y criterios de salida (exit criteria) |
| Transición a operación | Playbooks e instrucción al equipo responsable | Simulaciones de incidente + capacitación completada |
Guía paso a paso (orientativa):
Condiciones y requisitos típicos para pasar a producción (adáptalos a tu normativa):
Ampliación útil: criterios de salida (exit criteria) por tipo de prueba
Para evitar que “pasen” pruebas por completitud superficial, es recomendable definir exit criteria por categoría:
Estas condiciones ayudan a convertir la transición a producción en un proceso controlado y medible, en vez de una aprobación basada en “parece que funciona”.
Un error común es pensar que lo híbrido se resuelve únicamente conectando sistemas. En realidad, lo complejo es la coordinación: cómo se comporta el sistema cuando algo no coincide (datos incompletos, cambios de esquema, latencia o permisos).
Riesgos típicos:
Desde el punto de vista de ingeniería de fiabilidad, estos riesgos se mitigan con disciplina de gobierno, diseño de contrato de integración y un ciclo de pruebas que refleje el comportamiento real.
A continuación se amplían riesgos con ejemplos de cómo aparecen en la operación diaria:
Riesgo 1: cambios de esquema sin coordinación
Supón que un sistema destino cambia un campo: por ejemplo, “status” pasa de enum a string libre, o el formato de fecha cambia de ISO 8601 a otra convención. Si el contrato de integración no contempla versionado y validación, el flujo fallará o, peor, procesará datos incorrectos.
Mitigación: contratos explícitos con versionado; validación previa a la ejecución; y un pipeline de pruebas que detecte incompatibilidades antes del despliegue.
Riesgo 2: reintentos mal diseñados
Un error muy común es reintentar ante cualquier fallo sin discriminar tipo de error. Un 4xx suele indicar que el problema es del request (datos, permisos o formato), y reintentar no lo resolverá. En cambio, un 5xx o timeout podría ser recuperable.
Mitigación: clasificación de errores, políticas de reintento por categoría y límites para evitar tormenta de reintentos (retry storm).
Riesgo 3: ausencia de idempotencia
En sistemas híbridos, los duplicados son una fuente de incidentes de negocio. Si un mensaje se reentrega por culpa de un timeout o una caída temporal, el sistema destino podría crear dos registros.
Mitigación: idempotencia end-to-end: llaves por flujo, deduplicación por correlación, y contratos que incluyan “event id” o “request id”.
Riesgo 4: observabilidad sin contexto
Puede ocurrir que existan logs, pero no estén correlacionados. En ese caso, la observabilidad no responde el “por qué” sino que solo muestra piezas sueltas.
Mitigación: correlación consistente por flujo y por etapa; trazas que atraviesen fronteras; y dashboards orientados a negocio (por ejemplo, “% de pedidos creados correctamente” en vez de métricas técnicas sin significado).
Riesgo 5: seguridad con privilegios excesivos
Para “que funcione”, a veces se otorgan permisos amplios a la entidad que ejecuta la orquestación. Eso incrementa el riesgo de escalamiento de privilegios o exposición en caso de vulnerabilidades.
Mitigación: mínimo privilegio, segmentación por entorno, revisión periódica de roles y rotación de credenciales.
Además, un riesgo “silencioso” es el mantenimiento. Si la lógica está embebida en scripts o en configuraciones difíciles de versionar, cualquier corrección futura se vuelve lenta y costosa. En un esquema híbrido, ese costo se multiplica porque la solución interactúa con múltiples sistemas y cada uno puede cambiar.
Por eso, tratar Commander Hibrido como “solo integración” suele fallar por dos motivos: subestima coordinación (orquestación) y subestima gobernanza (ciclo de vida). La integración es apenas un componente del resultado; el sistema completo requiere disciplina.
En soluciones basadas en Commander Hibrido, el mantenimiento no es un evento: es un proceso. Si quieres resultados estables, implementa prácticas de continuidad:
Este enfoque reduce la probabilidad de que “funcione hoy” pero falle ante el próximo cambio del entorno.
Para extender esta idea, conviene incorporar prácticas adicionales que suelen mejorar la madurez operativa:
1) Registro de decisiones (Decision Records)
Cuando un equipo toma una decisión técnica (por ejemplo, “en este flujo reintentamos solo en timeouts” o “transformamos el campo fecha usando X”), debe quedar documentada con la motivación. Esto ayuda en auditorías y reduce el costo de onboarding. También evita que un nuevo integrante “deshaga” una decisión sin entender su contexto.
2) Gestión de backlog de dependencias
Un sistema híbrido depende de otros sistemas que cambian. Por eso, debe existir un backlog o canal para planificar cómo impactan los cambios upstream. Idealmente, cada integración tiene un propietario y un método para recibir avisos de cambios: changelog, reuniones con los equipos dueños, o mecanismos de notificación.
3) Reconciliación y reparación
Incluso con buena orquestación, ocurren fallas. Necesitas estrategia de reconciliación: por ejemplo, ejecutar procesos periódicos que identifiquen eventos atascados o estados inconsistentes, y corregirlos con seguridad.
Esto puede incluir:
4) SLO/SLAs orientados a negocio
Un sistema híbrido debe medir su desempeño en términos que el negocio entienda. En vez de “latencia de componente A”, mide: tiempo de procesamiento por flujo, tasa de éxito del flujo, y disponibilidad de procesamiento (porcentaje de ventanas donde el flujo opera correctamente).
5) Automatización de pruebas de compatibilidad
Cuando un sistema externo cambia, el impacto suele descubrirse tarde si no existen pruebas automatizadas. Una práctica madura es automatizar pruebas que validen compatibilidad del contrato: “dado un set de entradas, se genera el comportamiento esperado” y se detectan cambios en el esquema o semántica.
6) Game days con escenarios realistas
No basta con probar el “happy path”. Los game days deben incluir:
El objetivo es que la operación aprenda a manejar incertidumbre y no solo eventos predecibles.
Habitualmente se usa para describir un enfoque híbrido donde un “comando” o marco de operación coordina funcionalidades provenientes de distintos dominios o sistemas, buscando interoperabilidad, control y trazabilidad dentro de un flujo.
Puede presentarse como nombre de solución o como etiqueta conceptual. En la práctica, la diferencia se aclara con documentación de alcance, arquitectura objetivo e implementación concreta definida por tu proveedor o equipo.
Comienza por el caso de uso (estandarización de flujos, orquestación entre sistemas heterogéneos, visibilidad y auditoría). Luego verifica seguridad, modelo de integración, observabilidad y gobierno de cambios para confirmar que el diseño soporta tu operación diaria.
Un criterio adicional: pregunta “¿cómo se comporta ante fallos parciales?”. Si la respuesta solo habla de conectividad, pero no explica reintentos, idempotencia, compensaciones y trazabilidad, entonces probablemente falta una pieza de valor. Un enfoque híbrido debería permitir operar con resiliencia.
Como mínimo, pruebas de integración y regresión, y un plan para rendimiento acorde al volumen real o estimado. Además, valida manejo de errores (fallos parciales) y ejecuta un rollback ensayado.
En entornos críticos, también conviene:
Alcance, arquitectura, modelo de datos y contratos de integración, requisitos de seguridad, criterios de aceptación, evidencias de pruebas, plan de transición a operación, y responsabilidades por rol (quién monitorea y quién aprueba cambios).
Además, es recomendable pedir:
Indicadores típicos incluyen tasa de éxito por flujo, latencia, reintentos, errores por categoría, saturación de colas o recursos (si aplica), y métricas de auditoría que permitan investigación rápida ante incidentes.
Para hacerlo más accionable, añade métricas operativas y de negocio:
Sí, suele ser recomendable: un piloto con uno o dos flujos, medición de resultados, correcciones y expansión controlada. Esto reduce el riesgo y ayuda a consolidar el gobierno del cambio.
Una fase inicial útil es donde se prueba el “ciclo completo”: inicio del flujo, transformación de datos, seguridad, ejecución, reintentos, observabilidad y recuperación ante fallos. Muchas organizaciones hacen pilotos que solo validan “que llega del punto A al punto B” sin probar los bordes.
Frecuentemente: falta de trazabilidad, permisos no validados, observabilidad insuficiente, ausencia de rollback probado, o pruebas incompletas frente a fallos de integración y cambios de dependencias.
Otros frenos comunes:
Commander Hibrido puede convertirse en una ventaja operativa cuando se diseña con disciplina: alcance definido, seguridad robusta, interoperabilidad probada y observabilidad desde el principio. La compra o implementación no debe basarse en promesas, sino en criterios verificables: contratos de integración, evidencias de pruebas, gestión de cambios y plan de transición. Si aplicas este marco, el enfoque híbrido deja de ser una etiqueta y se convierte en un sistema confiable para coordinar la complejidad.
Un enfoque híbrido bien gobernado no solo “reduce fricción” entre sistemas; también reduce costo operativo y riesgo. Cuando el flujo se puede auditar, cuando las fallas se manejan con resiliencia, y cuando la configuración está bajo control de versiones con rollback ensayado, la organización gana estabilidad. Esa estabilidad es, en última instancia, el verdadero retorno de inversión de cualquier iniciativa híbrida: no la cantidad de integraciones, sino la capacidad de operar con confianza.
Nota de calidad: Este artículo no incluye precios ni detalles de proveedor específicos porque no se proporcionaron datos verificables en la solicitud. Si compartes el precio, el supplier y la ubicación exacta (o el contexto de “nearby”), puedo integrarlos en el texto manteniendo un enfoque objetivo y con criterios de evaluación.



Esta guía explica de forma objetiva qué es un Pulse Hibrido, cómo se interpreta su funcionamiento y qué criterios usar para evaluar opciones, mantenimiento y seguridad. Se revisa el contexto técnico de la terapia por pulso y los factores clínicos que suelen influir en la selección del equipo, incluyendo consideraciones de compatibilidad, protocolos y entorno de uso.
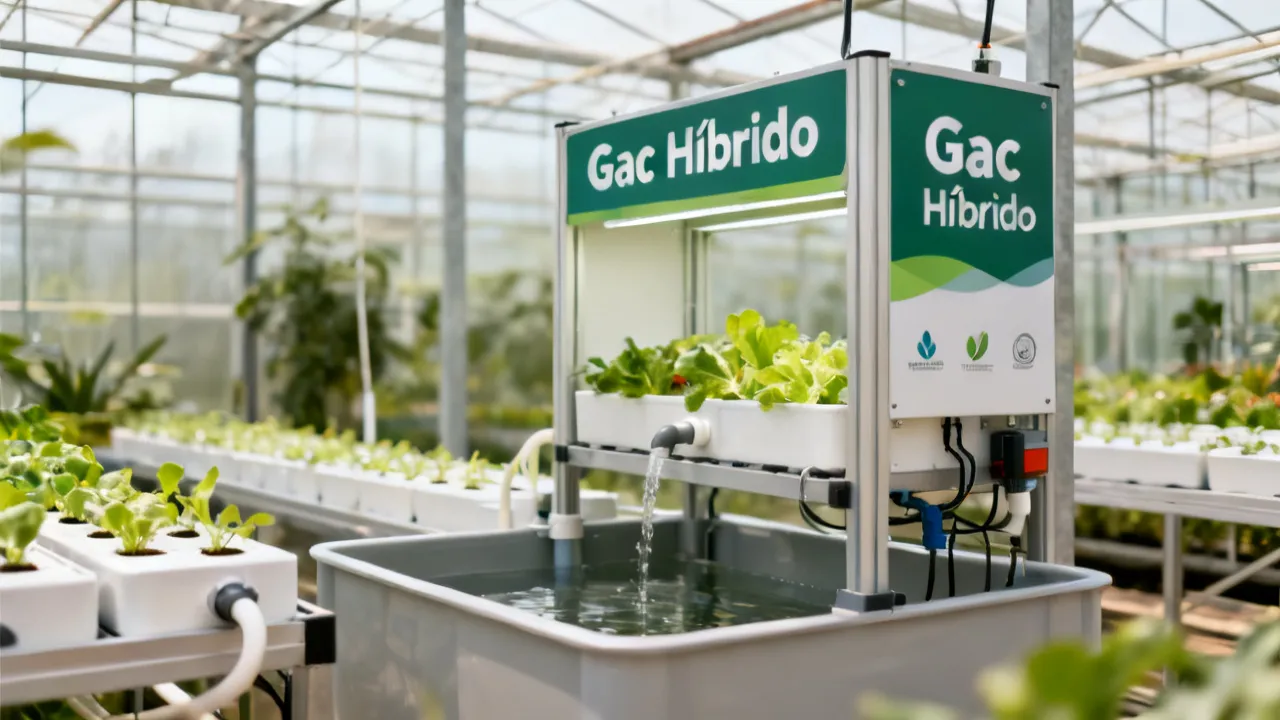
El Gac Híbrido se está posicionando como una opción técnica para quienes buscan combinar beneficios de sistemas y topar el manejo del cultivo o producción. Este artículo ofrece un panorama objetivo: qué suele significar “híbrido”, cómo se evalúa su desempeño, qué factores afectan costos y calidad, y cómo tomar decisiones informadas con base en criterios de proveedor, instalación y mantenimiento.
Esta guía explica, de forma objetiva, cómo se evalúa y aplica el Pulse Hibrido en contextos clínicos. Se revisa qué significa el concepto de “pulso” en fisioterapia y tecnología médica, por qué los sistemas híbridos combinan modalidades, y qué criterios técnicos y de seguridad se recomiendan para una selección responsable, alineada con protocolos y buenas prácticas del sector.
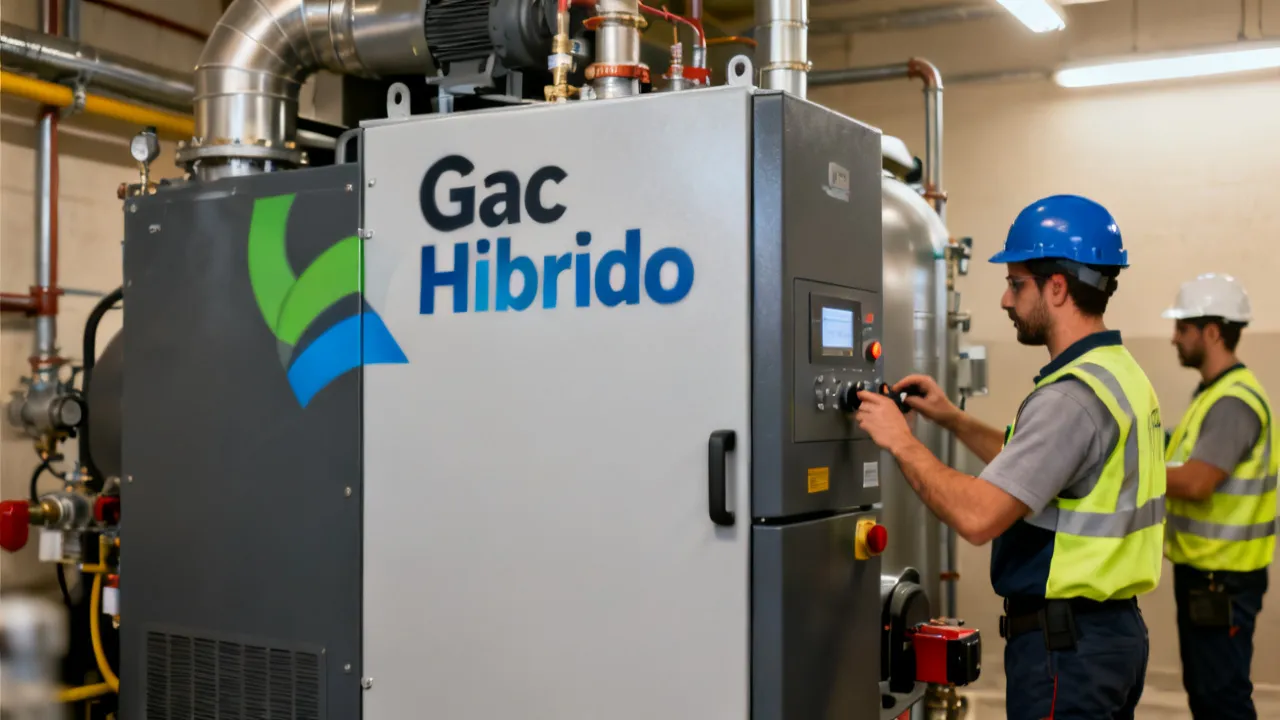
El Gac Híbrido combina rendimiento y versatilidad en sistemas de climatización y proceso, con una configuración diseñada para adaptarse a diferentes necesidades. Este artículo explica de forma objetiva qué significa el concepto “híbrido”, qué se considera en la selección técnica y qué requisitos suelen pedirse a proveedores e instaladores. Además, incluye comparativas, pasos de evaluación y preguntas frecuentes para tomar decisiones informadas.
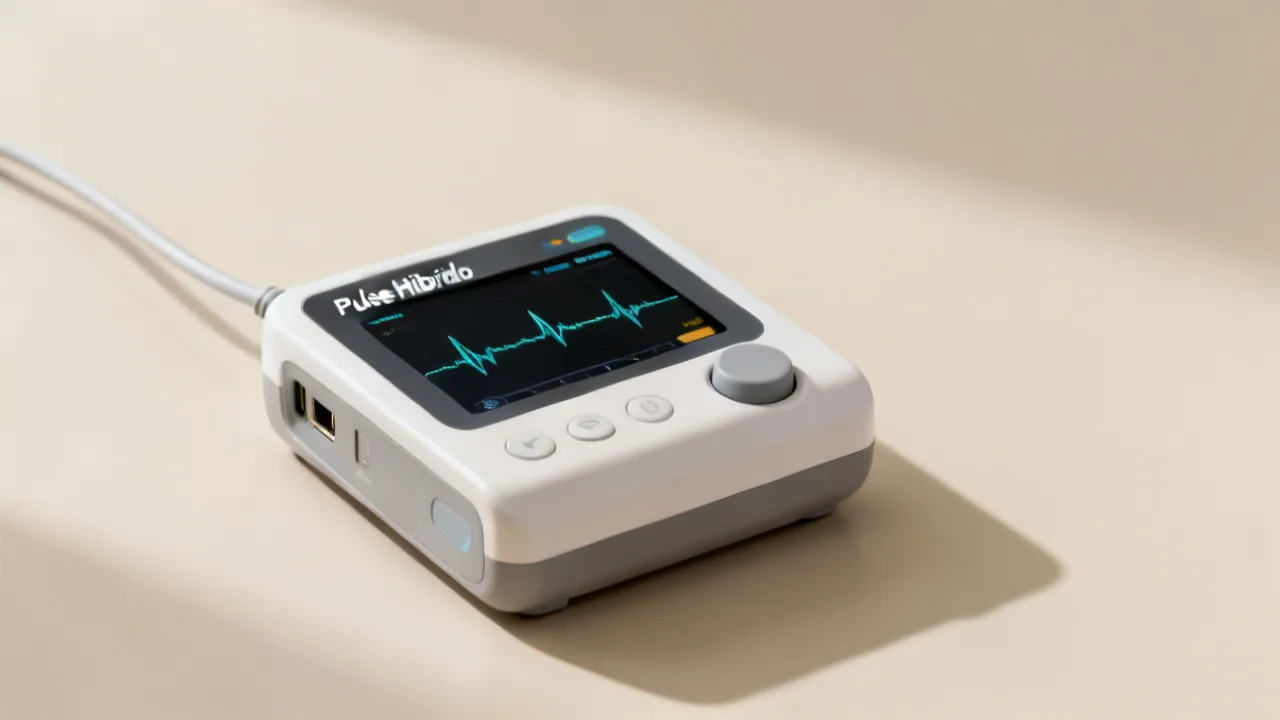
Esta guía explica qué es el Pulse Hibrido, cómo se integra en protocolos de estimulación y qué factores técnicos conviene revisar antes de seleccionarlo. De forma objetiva, se contextualiza su papel dentro de dispositivos de pulso, sus variables de configuración y el enfoque de seguridad clínica habitual. También se detallan criterios de compra, evaluación y mantenimiento para un uso responsable.
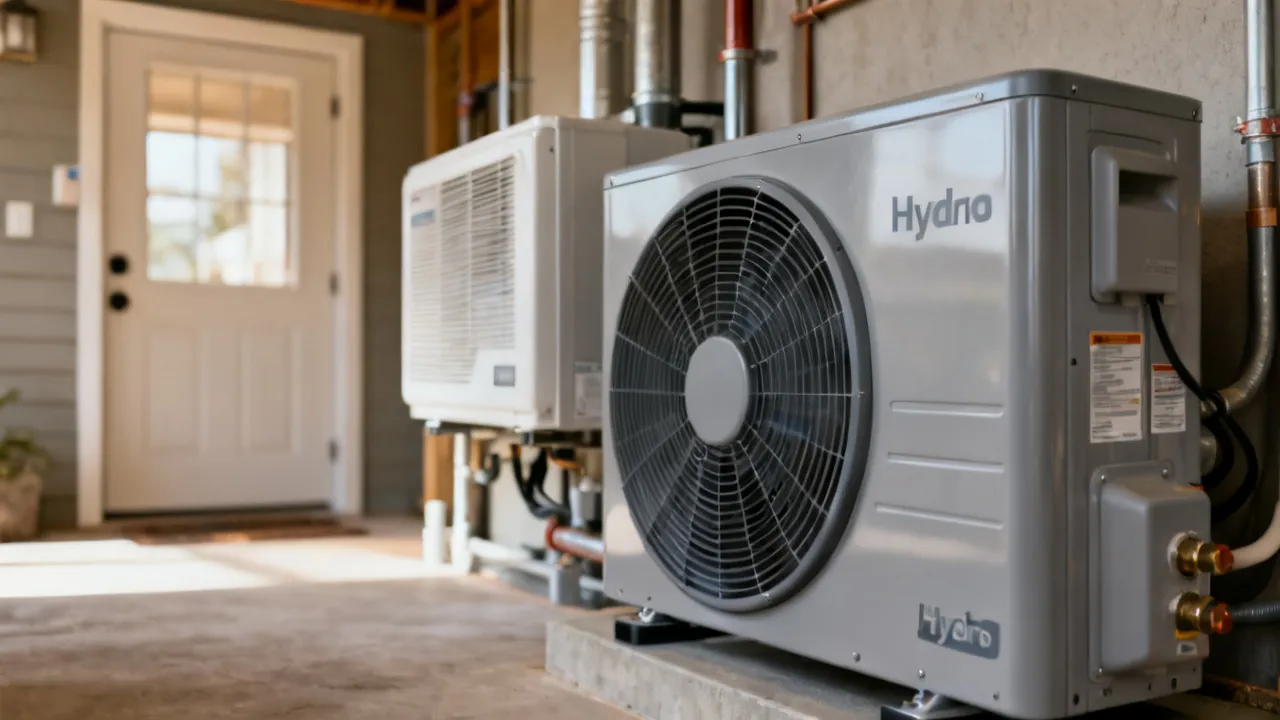
Esta guía analiza el sistema **Gac Híbrido** desde una perspectiva técnica y objetiva: qué es, cómo funciona y qué criterios seguir al evaluarlo para climatización. Se explican conceptos de la bomba de calor y la integración con otras fuentes térmicas, además de requisitos comunes de instalación y mantenimiento. También encontrarás comparativas, condiciones operativas y respuestas a preguntas frecuentes.

